机器学习项目技术选型与实践概览
按有无标签划分分类、回归和聚类,再按表格、文本、图像选路线。传统方法和深度网络不是互斥,先看数据量和要不要端到端特征。
按有无标签划分分类、回归和聚类,再按表格、文本、图像选路线。传统方法和深度网络不是互斥,先看数据量和要不要端到端特征。
从数据里学模式再预测新样本。用项目架构、技术栈和完整流程帮初学者选型,并给出学习路径,避免一上来就堆框架。
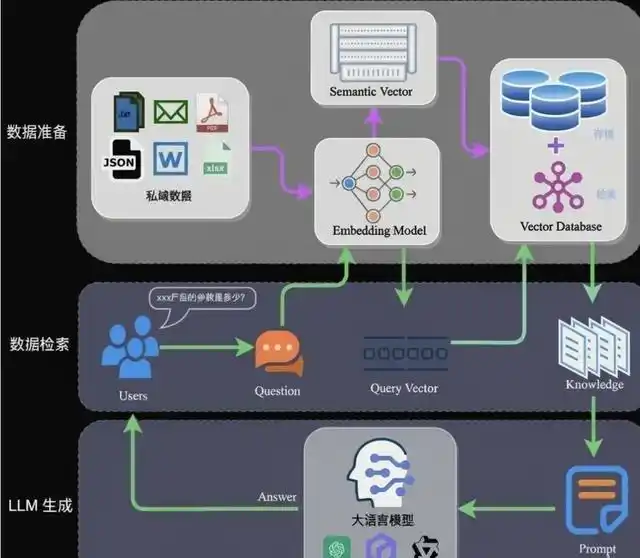
按「出问题再往前回溯」梳理路由分库、全文与向量检索、分块、重排和温度等配置。文档杂时先缩小检索范围,再决定要不要重排。
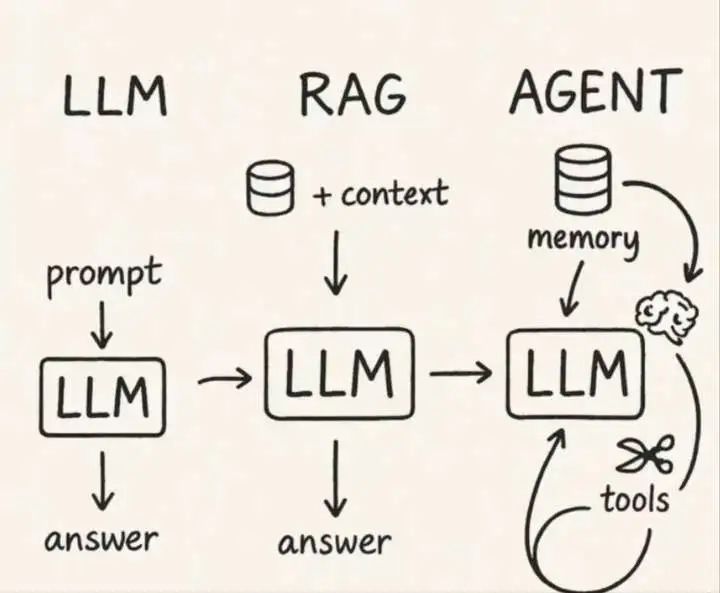
复杂业务先按清单核对关键因素,缺项就标出来反问,禁止从已有信息硬推缺失条件。简单问题直接结构化回答,避免装完整。
主库回答后强制列出相关附件,再用关键词到拆章后的附件库二次检索补全文。避免整篇入库带出无关章节,也不再为二次跳转另调大模型。
LightRAG 用图谱做检索增强,没有独立管理界面,配置全在环境文件里。给出容器接入大模型和嵌入服务的方式,以及和工作流节点怎么串。
开源大模型应用平台,工作流、知识库检索、智能体和模型管理一体。结合官方文档和开源流程文件,演示图表生成、知识检索和外部工具调用。
用实验追踪平台记训练过程,再用解释库出贡献度网页或报告。对照更重的一站式平台,说明许可、依赖和报告额外安装项。
用实体、关系和属性把文档收成图,便于多跳查询和按类型过滤,减少「详见附件」这类跨段问题靠纯文本相似度对不齐。节点和边要挂来源,便于审计。
说明本机 Ollama 的默认存储位置、模型目录如何组织,以及拉取、列出和删除等常用操作,便于管理多份开源权重和本地推理入口。