基于主次特征的群体聚类方案
行为频次等主特征用来分簇,年龄等次特征只做簇内统计。也可先按主特征划大类再在子集里细分。全部等权进距离会和业务直觉打架。
行为频次等主特征用来分簇,年龄等次特征只做簇内统计。也可先按主特征划大类再在子集里细分。全部等权进距离会和业务直觉打架。
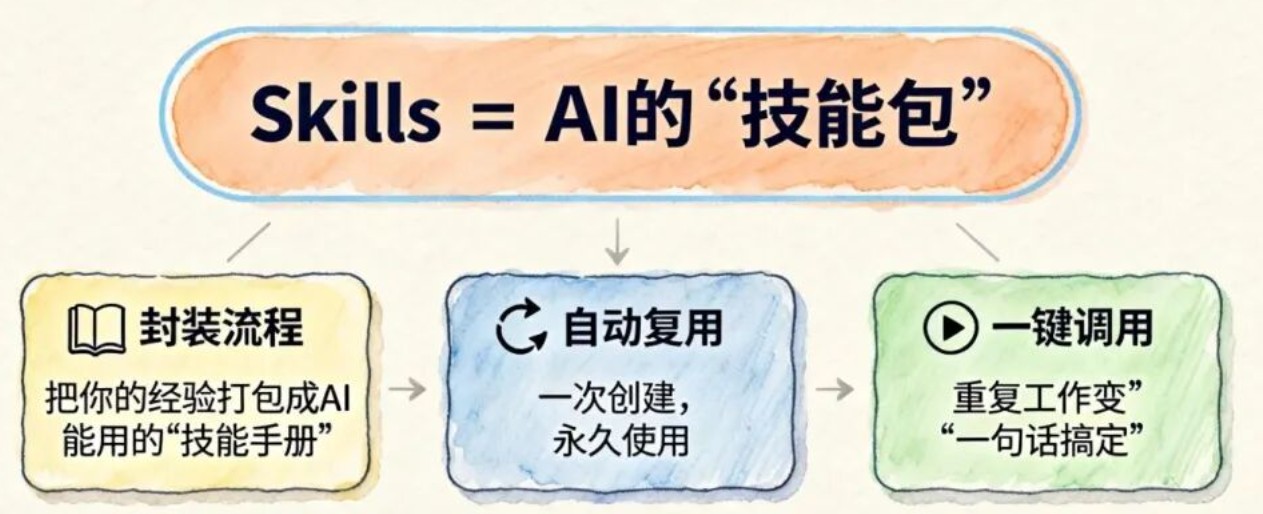
从飞书、邮件和文件蒸馏同事的工作规范与沟通风格,生成可独立调用的子技能,并支持列表、回滚和对话纠正。编排与脚本、提示词分目录维护。

命令行和 HTTP 走同一套引擎接口。Linux 默认只听本机套接字;要给程序调容器须打开 TCP 端口,明文和 TLS 端口含义不同,勿对公网裸放。
收录厂商发行、多智能体编排、本地控制台、便携盘和移动端等衍生仓库,并注明是否替代官方网关。Star 为检索时快照,许可证以各仓库为准。
按官方指南归纳缩放、非线性变换、类别编码、分箱和缺失填充。线性模型和距离类方法对尺度敏感,变换应放进流水线以免训练推理不一致。
标签编码只适合本身有序的类别,独热会涨维,目标编码要防泄漏。树模型有时能直接吃类别,线性模型把整数当间隔会引入假顺序。
Windows 上用本机网关接小米模型和飞书渠道,把本地笔记库当知识载体。技能通过命令行向模型暴露写入和检索,用户仍在即时通讯里对话。
按安装、升级、配置和使用整理本机网关,并收录飞书联调和常见问题。升级前宜停网关,命令行为随版本变化,以当时帮助与官网为准。
围绕排序指标:只关心正负样本谁排前,不关心概率绝对值。编号不当特征,目标编码须折内统计;多模型融合可把输出换成排名再平均。
索引里存抽出的正文做检索,原文件放对象存储供下载预览。抽取可在搜索引擎插件里做,也可在应用层抽完再写入,两条路按场景选。