Ontology企业本体论简介
Palantir 语境下的 Ontology 是原始数据与应用 / AI 之间的语义契约:对象、属性、链接、动作。它不存业务行,但决定大模型能查什么、能改什么、谁能改。不是数据库,也不是只读知识图谱。
Ontology企业本体论简介
本文按 Palantir 工程语境介绍 Ontology(企业本体):它是原始数据与应用 / AI 之间的语义契约层,不是数据库,也不是知识图谱。
参考与延伸阅读:
- Palantir Ontology 核心概念:https://palantir.com/docs/foundry/ontology/core-concepts/
- Palantir Ontology 系统:https://palantir.com/docs/foundry/architecture-center/ontology-system/
- 社区整理(腾讯云):https://cloud.tencent.com/developer/article/2739430
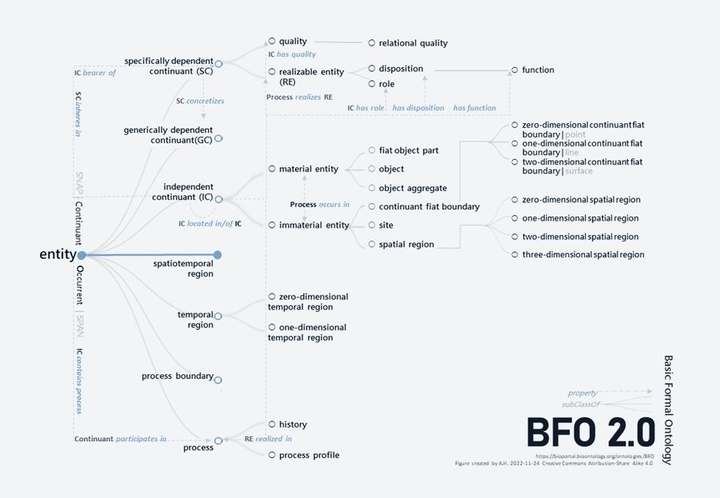
- 封面图 BFO 2.0:https://commons.wikimedia.org/wiki/File:BFO_ontology.jpg(AH-LOD,CC BY-SA 4.0)

目录
1. 定位
Palantir 约在 2018 年把产品线统一到 Ontology。在工程里,它指运行在生产环境、支撑大规模读写、决定大模型能否可靠行动的语义层。
结论性定义: Ontology 放在「原始数据」和「应用 / AI 推理」之间。它不存业务数据本身,但定义业务世界里有哪些实体(对象)、长什么样(属性)、彼此怎么连(链接)、能对它们做什么(动作)。上层应用、Agent、写回操作都必须经过这层契约。
常见误读:把 Foundry 当成数据平台、把 Gotham 当成知识图谱、把 AIP 调工具当成 LangChain 接 function。这些类比都漏掉了 Ontology 这一层。
2. 它首先不是什么
| 不是 | 原因 |
|---|---|
| 数据库 | 不持有记录行。表、流、API 仍在 Oracle、Snowflake、Kafka、Salesforce、S3 等原处。Ontology 在其上「物化」出对象。查 Customer 时,属性从底层源算出,不是对一张 Customer 表直接 SELECT。 |
| 普通知识图谱 | 图谱侧重节点、边、属性的存储与推理(如 Neo4j)。Ontology 的链接表达业务归属与关联,可带方向、约束和细粒度权限。更关键的是:图谱多为只读分析视图;Ontology 可写、可执行,内置 Action,能改变世界状态。 |
| ORM / schema 别名 | ORM 解决「对象怎么映射成表」。Ontology 解决「跨十几个异构系统的真实实体,如何在应用面前表现为一个统一、可操作的东西」。ORM 不管权限、实时物化,也不管让大模型安全调用能改生产数据的函数。 |
一句话:Ontology 是数据之上的语义与行为层。数据库是地基之一;知识图谱是近亲;它要取代的是每个应用自己写胶水代码去理解业务。
3. 对象、属性、链接、动作
3.1 对象(Object)
真实世界实体的数字化表示,例如航班、客户、风机、订单。对象不是一条数据库记录,而是记录经语义加工后呈现出来的「那个东西」。
- 每个对象有类型(ObjectType)和主键(Primary Key),在该类型下全局唯一。
- 一个 Customer 可能聚合 CRM 主档案、账单欠费、工单历史。对应用只是一个对象。
3.2 属性(Property)
对象上的强类型字段:string、integer、timestamp、geopoint、attachment 等。取值逻辑是声明式的:
- 直接映射:某张表的某列
- 派生计算:例如逾期天数 = 今天 − 应还日
对象形状由建模者定义的语义决定,不是由存储决定。
3.3 链接(Link)
对象之间的关系,例如「订单由客户下达」「风机属于风场」。双向可达:从订单到客户,从客户到其全部订单。底层可能是 join 或外键,对外暴露的是关系本身,上层用导航探索数据,而不必每次重写 SQL。
3.4 动作(Action)
对对象执行「改变」的唯一合法入口:创建对象、改属性、建立链接、触发服务端逻辑,都必须走 Action。动作是强类型、带参数、经校验、受权限约束、全程留痕的平台托管函数。
没有动作,Ontology 只是只读地图;有了动作,才成为能驱动业务的操作面。
3.5 ObjectType
四个元素合在一起构成 ObjectType:名称、主键、属性(类型与来源)、链接(指向谁、用什么键对齐)、可执行的 Action。可把 ObjectType 看成类、Object 看成实例;这个「类」里除了字段,还内嵌关系和行为。
ObjectType 不是表定义。表定义回答「数据怎么存」;ObjectType 回答「业务实体是什么、能怎么被理解和操作」。同一底表可以支撑多个视角、权限、派生属性不同的 ObjectType。建模自由度在语义层,不在存储层。
4. 物化
传统做法是先有表、灌数据、再查询。Ontology 反过来:对象实例不是被「存」出来的,而是被物化(materialization)出来的。
底层源(表、Kafka 流、REST 返回、甚至模型推理输出)变化时,平台按 ObjectType 上的映射规则,增量、近实时地计算并暴露对应对象。
Flight 示例
| 属性 | 来源 |
|---|---|
| 主键 | 航班号 + 日期 |
departureAirport | 航班计划表 |
actualTakeoff | 实时遥测流 |
delayMinutes | 派生:实际起飞 − 计划起飞 |
遥测来一条新事件时,不是去「更新某行」,而是重算该 Flight:delayMinutes 更新,看板、告警、Agent 下一刻看到新值。
工程要点:
- 源异构,物化统一。 同一对象的不同属性可来自不同系统,对齐到同一主键。应用只面对对象。
- 增量,不是全量重算。 维护对象与源数据血缘,只重算受影响部分。Palantir 由 Foundry transform 与 dataset 血缘支撑,沿血缘算出要刷新的对象,而不是定时轮询。
- 对象引用源,不持有原始副本。 物化产出的是视图状态,真记录在源里。换存储、改分区,只要映射不变,上层无感。同一底层事实可被多个 ObjectType 以不同视角同时物化(风控 / 营销 / 客服看到的 Customer 派生属性和权限不同,共享同一份真相)。
数据库要求先把数据放进来;Ontology 站在已有数据之上,用业务能听懂的语言再讲一遍。对散落在大量 legacy 系统里的数据,这一层把手写胶水变成声明式、可治理的建模。
5. 动作闸门
多数数据系统里,分析和执行是断开的:在 BI 里看到客户要流失,再切到另一个系统发券、改状态、派单。Ontology 的设计是:对象在语义层统一定义,改变对象的操作也必须同样被定义、约束、托管。
一个 Action 包含:
| 要素 | 含义 |
|---|---|
| 参数与类型 | 输入类型、是否必填、取值范围。例如「批准退款」含订单对象、金额、备注 |
| 校验逻辑 | 执行前必跑。简单约束(金额不能为负)或业务规则(状态须为「待退款」且不超过额度)。由平台保证,不靠调用方「记得检查」 |
| 权限 | 细到对象实例,可按属性动态推导(只能审批自己区域内的订单)。安全写在语义层,而不是每个应用各写一遍 |
| 执行与留痕 | 改对象状态并回写,或触发 Function / AIP Logic。留下 Action History:谁、何时、输入、做什么、结果如何 |
| 写回(write-back) | 对象修改经反向映射回到源系统。改的是对象语义,平台翻译成底层写入,并遵守源系统约束 |
无论人点按钮、规则引擎触发,还是大模型调起,只要改变世界,都必须经过这道闸门:类型、校验、权限、留痕。动作把 Ontology 从认知层接到操作层,这是它与知识图谱、数据湖、纯 RAG 的分野。
6. 大模型接地到 Ontology
大模型的老问题:不知企业私有数据会编;没有真实业务状态会乱说;直接改生产系统会失控。RAG 解决了喂知识,没有解决「动手」。让 LLM 直接生成 SQL 碰生产库更危险:没有语义约束、权限边界和留痕。
Palantir 把 Ontology 当作大模型的 grounding(接地) 层:暴露为一组工具。模型只能:搜索对象、读属性、沿链接导航、在满足条件下调用 Action。处理的是带类型、有业务含义、受约束的操作原语,不是表。
效果:
- 不幻觉结构。 面对的是 Customer 对象,不猜表名
cust_mstr还是t_customer。底表改名,模型无感。 - 不越权乱动。 调 Action 仍走校验和权限。
DROP TABLE不在工具集里。 - 每一步可解释、可回滚。 调用了哪个动作、传了什么参数、被哪条校验拦住,都在 Action History。
- 推理有边界。 AIP 运行时是「LLM 规划 + 受管函数执行」:模型提出要查什么、调什么;平台翻译成对 Ontology 的类型化调用,跑校验和权限,再把结果喂回。模型负责「想」,Ontology 负责「做」。
LLM 要参与企业决策与执行,不能只接向量库。它必须接到有结构、有类型、有行为、有权限的语义契约上。Ontology 是给 AI 用的世界模型接口,不是给 AI 用的数据库。把 AI 落地等同于「RAG + 几个 tool call」容易烂尾,根子往往是缺这一层:工具散、状态不统一、权限各写各的。
7. 和关系型 schema 的区别
| 层面 | 关系 schema | Ontology |
|---|---|---|
| 语义 | 描述如何存储:行、列、主键、外键。外键是指针,不携带业务含义 | 链接是关系本身:归属、依赖、因果。看到的是「设备隶属于产线,产线服务于工厂」 |
| 行为 | 静态,不定义能做什么;改数据全凭应用自己写 | Action 是类型系统和契约的一部分。「能被怎么改变」与「长什么样」一样被建模 |
| 权限 | 通常在表、行、列或视图上,与业务语义脱节 | 作用在对象实例和动作上,可按属性动态推导;所有应用和 Agent 自动遵守 |
| 稳定 | 底表重构、换存储、改分区,下游应用易崩 | 存储演进与语义稳定解耦;映射规则保持,上层对世界的理解不变 |
Ontology 不是好看的表,而是架在 schema 之上、关于「业务世界如何被理解、被操作、被保护」的契约。它不取代数据库,而是让数据库用语义说话。
8. 小结
| 要点 | 结论 |
|---|---|
| 数据库 | 告诉你数据在哪 |
| 知识图谱 | 告诉你关系在哪 |
| Ontology | 告诉你在这个业务里什么是真的、什么能改、谁能改、改完留下什么 |
| 对大模型 | 接地层:只能搜对象、读属性、沿链接走、在权限内调 Action |
Palantir 常被引用的话是「我们卖的不是数据,是决策」。Ontology 是支撑这句话的技术实体:把散乱原始数据收敛成对象、属性、链接、动作,让人和 AI 在同一个受控、有行为的世界里做决定并执行。这是 Palantir 架构的核心,也是 AIP 能让大模型进生产的底座。