RAG工作流使用简介
把知识库检索接到智能体工作流后,不必先自建后端也能做场景问答。本文按单库提示词、意图分库、参数自检与多轮三条路线说明节点怎么串,并补评测、可观测和重排混合召回。示例平台为 FastGPT 一类工作流,场景已脱敏。
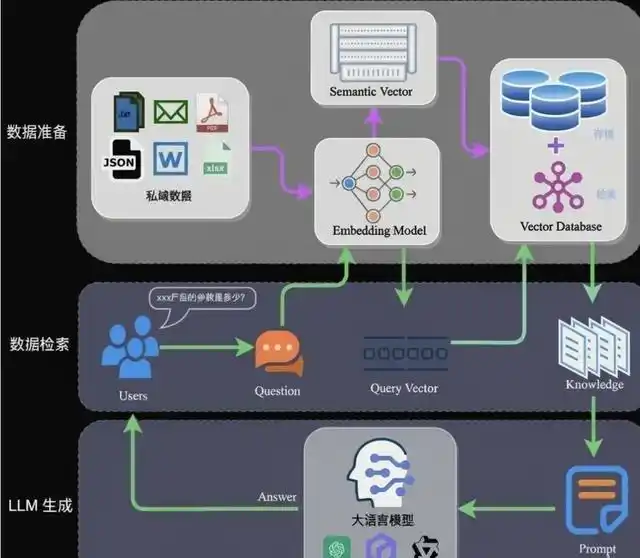
RAG工作流使用简介
面向知识库问答助手:用智能体平台的 Workflow 把「用户问题 → 检索 → 生成」串成可迭代的主路径,而不是只靠一个大 Prompt。下文以 FastGPT 一类可视化工作流为例,节点在 Dify 等平台可对照实现。场景取自某业务问答试点的脱敏抽象,不是特定项目落地手册,也不替代行业规程。
参考与延伸阅读:
- FastGPT 文档:RAG 定义
- Dify:中文 README、工作流入门
- RAGFlow:中文 README
- LangGraph:LangChain AI
目录
- 一、工作流在 RAG 里解决什么问题
- 二、常见平台与选型
- 三、知识库准备与检索节点
- 四、v1 朴素单库
- 五、v2 意图路由与分库
- 六、v3 参数自检与多轮上下文
- 七、三版对照
- 八、问答效果评测
- 九、可观测与对外集成
- 十、检索侧再加一层
- 十一、小结
一、工作流在 RAG 里解决什么问题
纯 Chat Bot 把「检索 + 推理 + 拒答 + 追问」全塞进提示词,常见结果是:串库、漏参数仍给确定结论、多轮指代丢失。工作流把这些拆成节点,由边决定下一步。
| 能力 | 纯 Bot | 工作流 |
|---|---|---|
| 检索范围 | 一次打全库 | 可按意图进子库 |
| 缺关键参数 | 容易瞎编等级 | 可先反问再检索/生成 |
| 多轮指代 | 依赖模型自觉 | 显式拉历史、问题补全 |
| 范围外问题 | 容易硬答 | 固定引导节点 |
| 迭代方式 | 改一整段 Prompt | 改一条边或一个节点 |
适用:制度问答、定级助手、客服知识库等「文档边界相对清楚」的场景。
不适用:要对接核心业务库、强事务、强审计落库的生产系统——那是工作流之外的服务层。
二、常见平台与选型
| 路线 | 代表 | 特点 |
|---|---|---|
| 可视化工作流 + 内置知识库 | FastGPT、Dify | 检索节点、分类节点、对话节点开箱即用,适合快速搭助手 |
| 文档解析与图谱偏重 | RAGFlow | 强调切块、引用溯源,后续可接到 GraphRAG 一类能力 |
| 代码编排 | LangGraph 等 | 状态机完全自控,适合已有工程栈、要进 CI 的团队 |
选型不必一次到位:演示和试点用可视化平台即可;节点职责想清楚后,再迁到自建编排成本更低。
场景:某园区需要同时回答「水库测点水位定级」和「道路事故伤亡定级」。两套条文、两套关键参数,混在一个 Bot 里最容易串库。下文三条工作流都围绕这个抽象场景。
三、知识库准备与检索节点
入库前只做三件事,不必把原文整篇贴进助手配置:
- 一条业务线一份库。测点水位与事故伤亡不要先合进同一个数据集。
- 按条款/区间切块,避免按固定字数切断「以上含本数、以下不含」这类判定句。
- 检索节点绑定库,而不是把全文塞进 System Prompt。Prompt 只写职责、拒答和输出格式。
平台侧常见检索参数(名称因产品而异):相似度阈值、引用 token 上限、混合召回、是否重排、是否问题补全。v1 往往引用上限偏紧、历史轮数极少;后面两版主要改这些,而不是换模型。
四、v1 朴素单库
全部文档丢进一个合并库,提示词要求「只根据知识库回答、不要编造数字和等级」。链路最短,用来验证「能不能答」,不用来验证「答得准」。
1
2
3
4
[开始] 用户问题
    → [知识库检索] 合并库(两套条文一起召回)
    → [LLM 对话] 单提示词 + 引用片段
    → [结束]
| 节点 | 职责 |
|---|---|
| 开始 | 接收本轮用户输入 |
| 合并检索 | 向量 / 混合召回,引用长度通常偏短 |
| 对话 | 低温生成;历史往往只留 1 轮 |
典型失败:问水位时召回事故条款;用户先报位置、下一轮只补数字,模型已经不记得位置;引用被截断后,区间边界丢失,等级跨档。
五、v2 意图路由与分库
先分类,再进对应子库和专项对话节点。分类用小模型即可,不必占用主力生成模型。
1
2
3
4
5
6
7
8
9
10
11
12
13
[开始] 用户问题
    → [意图识别 / 问题分类]
         ├─ 水库水位与应急
         │      → [子库检索 A] 仅水位/测点条文
         │      → [子智能体 A] 专项提示词 + 引用
         │      → [结束]
         ├─ 园区事故伤亡定级
         │      → [子库检索 B] 仅事故条文
         │      → [子智能体 B] 专项提示词 + 引用
         │      → [结束]
         └─ 打招呼 / 知识库以外
                → [固定回复] 说明能力范围,引导补全场景
                → [结束]
分类背景只需写清互斥类别和关键词簇,例如:水位、汛限、大坝、安全等级走库 A;死亡、重伤、事故等级走库 B;闲聊与无关问题走「其他」。
串库会明显下降,但 v2 仍可能在「参数不全」时给出确定等级,多轮补充也容易断。
六、v3 参数自检与多轮上下文
拓扑与 v2 相同,改的是检索窗口、历史轮数、问题补全,以及生成前的自检。
1
2
3
4
5
6
7
8
9
10
11
12
13
[开始] 用户问题(可带历史)
    → [意图识别] 必须看聊天记录;用户只补数字时沿用上一轮类别
         ├─ 库 A
         │      → [子库检索] 提高引用上限 + 开启问题补全(处理「刚才那个水位」)
         │      → [子智能体]
         │            ├─ 缺「位置」或「水位数值」→ 只追问缺失项,禁止输出确定等级
         │            └─ 参数齐全 → 按引用区间判定 + 处置要点
         ├─ 库 B
         │      → [子库检索] 同上
         │      → [子智能体]
         │            ├─ 缺死亡人数或重伤人数 → 追问另一项
         │            └─ 参数齐全 → 按就高原则定级
         └─ 其他 → [固定回复]
| 调整项 | v2 常见取值 | v3 方向 |
|---|---|---|
| 引用 token | 偏紧,易截断区间句 | 明显加大(示意到数千级) |
| 对话历史 | 1 轮 | 多轮(示意 8 轮) |
| 问题补全 | 可关 | 打开,补指代与缺省槽位 |
| 提示词 | 只要求「根据知识库答」 | 自检清单:缺槽位先问,禁止编造 |
自检是提示词约束,不是代码校验。演示够用;若等级错误不可接受,应把「槽位是否齐全」做成代码 / 条件节点,通过后再进生成。
七、三版对照
| 维度 | v1 朴素单库 | v2 分库路由 | v3 自检多轮 |
|---|---|---|---|
| 检索范围 | 全库 | 按意图子库 | 同 v2,窗口更大 |
| 串库 | 高 | 低 | 低 |
| 缺参仍给结论 | 常见 | 仍常见 | 提示词强制先问 |
| 多轮补数 | 易丢 | 仍弱 | 历史 + 问题补全 |
| 搭建成本 | 最低 | 多几条边 | 在 v2 上改参数和 Prompt |
迭代顺序建议:先能跑通 → 再分库 → 再补槽位与上下文。不要在 v1 上堆 rerank 和图谱。
八、问答效果评测
工作流改完要用金标准看回归,而不是只看几次手测。
1
2
3
4
5
准备 Q/A 金标准(问题 + 标准结论,含缺参应追问的样本)
    → 批量调用同一工作流
    → 收集模型输出
    → LLM-as-Judge 对照标准答案打分
    → 按题型拆:定级对不对 / 该不该追问 / 是否串库
样本要覆盖:参数一次给齐、分两轮补齐、数字差一档、问 A 场景却夹 B 关键词、范围外闲聊。自动打分只作筛选,边界题仍需人工抽查。
九、可观测与对外集成
线上要能回答「这次检索到了哪几段、分类走了哪条边、生成用了哪些引用」。常见做法是把 trace 打到 Langfuse 一类平台,再与 RAGAS 等离线指标配合:后者算分,前者存链路和版本对比。
对外形态通常只有两种:
| 方式 | 说明 |
|---|---|
| HTTP API | 业务系统把用户问题转进来,拿回答案与引用 |
| 页面嵌入 | 门户悬浮窗、iframe,会话仍走同一条工作流 |
不要为每个入口复制一套 Prompt。入口只负责鉴权与展示,主路径仍是这一张图。
十、检索侧再加一层
分库和自检稳定之后,再考虑检索质量:
1
2
3
4
5
6
7
用户问题(可先改写 / 补全)
    → 双路召回
         ├─ 向量:语义(「漫坝临界怎么办」)
         └─ 关键词 / BM25:精确编号与水位数字
    → 融合(如 RRF)
    → 可选 Rerank:交叉编码器按「问题–段落」细打分
    → 截 Top n 送给生成节点
数字只差一档、条款编号必须命中时,重排往往比单纯加大 K 更有效,代价是多一截模型和延迟。v1~v3 演示可以先关掉 rerank,避免把「路由问题」和「检索排序问题」搅在一起。
可视化工作流只是助手形态之一。知识图谱、智能问数、多智能体课堂等是另一条产品线,和「检索节点 + 对话节点」不是互相替代,需要单独选题:
| 形态 | 参考 |
|---|---|
| 知识图谱 | LightRAG |
| 智能问数 | SQLBot |
| DeepSeek Harness | deepseek.com/harness |
| 多智能体互动课堂 | OpenMAIC、open.maic.chat |
| 一人 AI 原生公司 | OpenOPC |
十一、小结
| 要点 | 结论 |
|---|---|
| 主路径 | 用工作流显式串检索与生成,不要把状态机写进一段 Prompt |
| 先分库 | 文档边界清楚时,意图分类 + 子库比加大合并库更有效 |
| 再自检 | 定级类问题先收齐槽位,缺参只追问 |
| 评测 | 金标准要含「该追问」样本,不能只测一次提问 |
| 检索增强 | 混合召回和 rerank 放在路由稳定之后 |
从合并库到分库再到多轮自检,改的是边和节点职责,不是换一个更大的模型。