智能体记忆管理组件调研
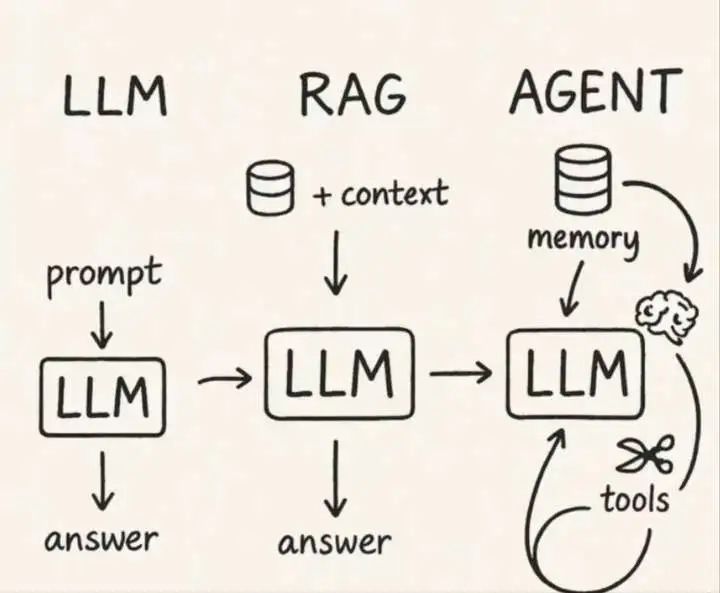
梳理 GitHub 高星 Agent 记忆组件:Mem0 一类抽事实再检索,Letta / OpenClaw 做梦境巩固,Graphiti 走时序图谱。跨 Agent 共享靠作用域、图库或 Git,而不是无锁共写一份 Markdown。文末对照选型与其余能力。
智能体记忆管理组件调研
面向 Agent 记忆管理 的开源组件近年集中出现。本文按 GitHub 高星仓库与公开文档,归纳记忆检索、分时压缩 / 梦境、跨 Agent 共享,以及记忆层常见的其余能力。星数与接口以仓库当时说明为准,不是吞吐或召回评测。
参考与延伸阅读:
- Mem0:https://github.com/mem0ai/mem0
- Graphiti(Zep):https://github.com/getzep/graphiti
- Cognee:https://github.com/topoteretes/cognee
- Supermemory:https://github.com/supermemoryai/supermemory
- Letta(原 MemGPT):https://github.com/letta-ai/letta
- MemOS:https://github.com/MemTensor/MemOS
- GPTCache:https://github.com/zilliztech/GPTCache
- OpenClaw Memory:https://docs.openclaw.ai/concepts/memory
- OpenClaw Dreaming:https://docs.openclaw.ai/concepts/dreaming
- Letta Sleep-time Compute:https://www.letta.com/blog/sleep-time-compute/
- OpenAI Prompt Caching:https://developers.openai.com/api/docs/guides/prompt-caching
- CrewAI Memory:https://docs.crewai.com/concepts/memory
- agentcache:https://github.com/masteragentcoder/agentcache
- Mem0 论文:https://arxiv.org/abs/2504.19413
- Sleep-time Compute:https://arxiv.org/abs/2504.13171
- Don’t Break the Cache:https://arxiv.org/html/2601.06007
目录
一、高星仓库速览
下列星数来自调研当时的公开页,只作量级参考。
| 仓库 | 约 Star | 形态 | 记忆怎么存 |
|---|---|---|---|
| mem0ai/mem0 | 6.6 万 | 记忆 CRUD API,可托管可自建 | 抽取事实;向量 + 可选图谱;按 user_id / agent_id / run_id 分作用域 |
| getzep/graphiti | 3.1 万 | 时序知识图谱框架,Zep 的开源核 | 实体/关系带时间有效期与 superseded |
| topoteretes/cognee | 3.0 万 | 自托管图谱 + 向量记忆平台 | ingest → 构图 → 检索;会话结束可写入永久图 |
| supermemoryai/supermemory | 2.9 万 | 记忆 / 上下文 API + 插件 | 画像、连接器、混合检索;有 OpenClaw / Claude Code 插件 |
| letta-ai/letta | 2.5 万 | 有状态 Agent 运行时(原 MemGPT) | 核心 Memory Block 常驻上下文;档案库语义检索;MemFS + Git |
| MemTensor/MemOS | 1.1 万 | 记忆操作系统 | 分层(轨迹 / 记忆 / 世界模型)+ 技能结晶;宣称可降 token |
| zilliztech/GPTCache | 0.8 万 | 语义缓存,不是长期记忆 | 问句向量相似则直接返回旧回答 |
| letta-ai/letta-code | 0.3 万 | Letta 现用 harness | /sleeptime 梦境、MemFS、技能学习 |
| LangMem | 约 0.16 万 | LangGraph 侧工具库 | 语义 / 情景 / 程序记忆 + 后台 manager |
| OpenClaw | 产品级 Agent | 工作区 Markdown 为源 | 日文件 + MEMORY.md + 可选向量检索 + Dreaming |
另有 Honcho、OpenMemory(Mem0 的本地 MCP)、Basic Memory(Obsidian 风格 Markdown MCP) 等,星数低于上表头部,但代表「本地文件 / MCP 侧车」这条线。专门做 多 Agent 共用 Prompt 前缀 的 agentcache 星数不高,机制写得很直白,下文单独引用。
二、推理缓存、语义缓存与记忆检索
和「记住用户是谁」并列、但经常被放进同一张产品页的,还有两类缓存。它们不替代长期记忆,接口和失效策略也不同。
2.1 前缀缓存:Prompt / KV Cache
云厂商 Prompt Caching 与本地推理引擎的 Prefix / Radix KV Cache 都会复用提示开头已经算过的 KV。命中后跳过这段 prefill,输入按「读缓存」计价(折扣以厂商账单为准)。从提示开头起,连续 token 须与已缓存前缀一致;系统提示、工具 JSON、消息顺序任一处变化,都会从分叉点开始重算。
论文 Don’t Break the Cache 指出:长程 Agent 里,把每轮都变的内容放在提示前部、或每轮重排工具表,会降低命中率。常见做法是把系统提示、工具定义、稳定人设放在前部,本轮用户话和工具结果放在尾部。
agentcache 让子 Agent 从父会话的不可变前缀 fork,以便命中 Anthropic / Gemini / OpenAI 的 Prompt Cache。其给出的高命中率指的是 fork 之后对共享前缀。
本地 vLLM / SGLang 的 RadixAttention 同类:树节点按 token 前缀共享 KV。
2.2 语义缓存:相似问句直接返回旧答
GPTCache 在客户端把用户问题做成向量,阈值内视为同一问,直接返回上次 completion。这是 问答对缓存,不要求前缀相同,也不构成长期人格记忆。适合 FAQ、重复工具参数、评测回放;用户偏好已变更时需要 TTL 或显式失效。
2.3 记忆检索:抽事实,下轮只回灌相关条目
Mem0、Zep/Graphiti、Cognee、Supermemory、MemOS 的主流做法是:不要把整段聊天塞进窗口。用 LLM 抽事实 → 写入向量 / 图谱 → 下轮只召回 Top-K。Mem0 公开基准里把单次检索预算压到数千 token 量级。检索块每轮内容不同,应放在提示后部或作为工具结果,不宜写入系统提示前部。
下面用 Mem0 + 跨周助手 把这条链路走完。人物与项目均已脱敏。
场景。 用户甲是某企业的实施顾问。周一在助手里闲聊、排期、改偏好,累计二十多轮。下周五只丢一句:「按我习惯写一份本周周报提纲。」若把周一到周五的原文全部拼进 prompt,模型要再读一遍寒暄、贴日志、改口。Mem0 的目标是:长期只存几条可复用事实,提问时只把相关的几条塞回去。
应用侧固定带 user_id="user-jia"(可再加 agent_id 区分不同 Bot)。Mem0 夹在「业务应用」和「对话模型」之间:应用决定何时 add、何时 search、检索结果怎么拼进提示。
周一:对话发生之后调用 add。 应用把本轮(或刚结束的一小段)消息交出去,不必也不该把几个月的全文每次重传。官方说明里,托管平台会按同一 user_id(以及可选的 run_id)自行拼近期上下文,用来消解「他 / 那个仓库」之类指代。
假设本段原文大意是:
1
2
3
用户甲:我负责客户 A 的实施,周报只要风险和阻塞,不要过程流水账。
助手:记下了,以后周报按风险和阻塞来。
用户甲:代码在 GitLab,合并前必须过流水线。群里不要直接 @ 分管领导。
Mem0 在 add 内部大致做四步(对应官方 How it works):
| 步 | 做什么 | 本例结果 |
|---|---|---|
| 1. 查已有记忆 | 按同一 user_id 找出可能重复的旧事实,避免再存一条一模一样的 | 库里还没有「周报格式」,通过 |
| 2. 抽取事实 | 另一次(或单次)LLM 调用,从对话里抽出可复用的偏好、决策、计划,丢掉寒暄和助手套话 | 「用户甲负责客户 A 实施」「周报只要风险与阻塞」「代码托管 GitLab,合并前过流水线」「群内不 @ 分管领导」 |
| 3. 去重并向量化 | 冗余句删除;每条记忆做成 embedding,写入向量库 | 四条短事实,而不是二十轮 transcript |
| 4. 抽实体并挂图 | 抽出人名、项目、产品等;平台版会链到 Graph Memory,检索时靠实体加分 | 实体如「客户 A」「GitLab」;之后问「那个客户」也能打到同一簇 |
库里此时没有完整聊天记录,只有这些 短事实。infer=False 才会按原文存消息,官方默认走抽取,重复插入同一事实容易变成两条,生产上要选一种模式并保持一致。
下周五:模型调用之前先 search。 用户甲只说:「按我习惯写一份本周周报提纲。」应用 不要 把周一全文贴回去,而是:
- 用这句(或稍作扩写的检索问句,如「周报格式与沟通禁忌」)调用
search,filters={"user_id": "user-jia"},top_k取 5~10。 - Mem0 把问句做成向量,融合语义相似、关键词(BM25)、实体重叠、时间信号后排序。问句里的「周报」「习惯」会打中「只要风险和阻塞」;不一定带回「GitLab 流水线」,因为本轮用不上。
- 应用把返回的 2~4 条记忆拼成一小段,追加在提示尾部(或作为工具结果),再请求对话模型。
拼进去的上下文接近:
1
2
3
4
5
相关记忆:
- 用户甲负责客户 A 的实施。
- 周报只要风险和阻塞,不要过程流水账。
- 群内不要直接 @ 分管领导。
用户:按我习惯写一份本周周报提纲。
对话模型只看见这几行,即可写出带风险/阻塞结构、且不 @ 领导的提纲。GitLab 那条仍躺在库里,等以后问「合并门禁」再被召回。
和整段历史相比。
| 不接记忆层 | 接 Mem0 | |
|---|---|---|
| 发给对话模型的历史 | 跨周全部轮次,随时间线性涨 | 每轮 Top-K 事实,长度近似恒定 |
| 周一寒暄、改口、贴日志 | 每次重读 | add 时已丢掉,不进周五的 prompt |
换设备 / 新 run_id | 会话一断就忘 | 仍按 user_id 搜到同一批事实 |
Mem0 公开基准把单次检索预算压在数千 token 量级,依据的就是这种「只回灌相关事实」。周五那句以前没出现过,仍然要调对话模型生成周报;Mem0 不替代生成,只缩短需要重读的历史。
三、梦境与日周月压缩
「像人睡觉时巩固记忆」来自 MemGPT / Letta 的 sleep-time compute(arXiv:2504.13171):主 Agent 继续对话,后台另开一个 sleeptime / dreaming 子 Agent,读近况、整理核心 Memory Block 与档案库,避免在用户等待时抢工具步。Letta Code 里用 /sleeptime 配置按步数或上下文压缩事件触发。
OpenClaw 把同一动机落成 工作区文件 + 定时巩固:
| 文件 | 角色 |
|---|---|
USER.md | 稳定人设与偏好,会话开头加载 |
MEMORY.md | 精选长期事实与决策,不是流水账 |
memory/YYYY-MM-DD.md | 当日观察与过程;默认加载今天和昨天 |
DREAMS.md | 梦境扫掠的人工可读纪要 |
巩固过程 不是「每天用向量模型把对话压成更短向量当正文」。向量(及 BM25 混合检索)只给 memory_search 用。晋升路径是:
- 会话中把值得留下的内容写入日文件或直接写入
MEMORY.md。 - 压缩前可做 memory flush:静默提醒模型先落盘,再摘要窗口。
- Dreaming 默认定时(如凌晨 cron):从 SQLite 短时回忆信号打分,过门槛后用 无工具的补全 决定对
MEMORY.md的新增 / 合并 / 取代;失败则退回只追加。 - 日文件可做 grounded backfill,复盘历史笔记,但不直接覆盖长期层。
社区 fractal-memory 再叠一层日历金字塔:
1
2
原始对话 → 日日记 → 周滚动 → 月滚动 → MEMORY.md
                 ↘ 不随时间失效的 sticky-notes
日 / 周 / 月末用脚本(常再调一次 LLM)做 rollup。加载顺序刻意做成 今天 → 本周 → 本月 → 核心索引,让注意力落在新信息上。这是 层级摘要,和 Generative Agents 的周期反思同一族。
Mem0 类 API 通常不按日历切文件:每条消息(或一批)抽取、去重、更新事实。时间能力靠时间戳与「当前 / 过去 / 计划」检索,而不是 2026-10-03.md。Graphiti 则给每条事实 valid_at / invalid_at,问「周二当时知道什么」走图,而不是读那天的 Markdown。
| 路线 | 压缩谁做 | 向量做什么 | 适合 |
|---|---|---|---|
| Letta sleeptime | 后台子 Agent 改 Memory Block / 档案 | 档案库语义检索 | 长期存活、要自学的单个 Agent |
| OpenClaw Dreaming | cron + 门控 LLM 改 MEMORY.md | 给 Markdown 建混合索引 | 本地工作区、人要能打开文件审查 |
| 日周月 Fractal | 日历脚本 + LLM 摘要 | 可选检索 | 日记会积成几百个文件时 |
| Mem0 / 图谱抽取 | 每轮或批量 LLM 抽事实 | 主存储之一 | 多应用、多用户、要 CRUD API |
向量模型 不负责「把一天对话压成一段更便宜的记忆正文」。正文压缩仍是 LLM 摘要或结构化抽取;embedding 只解决「换一种问法还能找回」。
四、跨 Agent 记忆共享
共写一份 Markdown、不加锁、当总线,几乎只出现在演示里。高星实现用的是 带作用域的存储服务 或 显式共享对象。
4.1 同一条记忆总线,用 ID 切开
Mem0 文档给出四个作用域:user_id(用户长期)、agent_id(某个角色私有)、run_id / session(本轮)、app_id(应用默认)。客服 Bot 与经理 Agent 检索时带 同一个 user_id,就能共享用户偏好;各自的 agent_id 避免把内部草稿泄漏给对方。存储是向量库 + 可选图,不是文件锁。
CrewAI 统一 Memory:Crew(memory=True) 时全员默认共享;需要隔离时 memory.scope("/agent/researcher"),需要「私有 + 公共」并集时用 MemorySlice。默认存储可落到 LanceDB 一类嵌入库。
4.2 共享块、共享 Git、共享图
Letta 允许 多个 Agent 挂同一块 Memory Block:改一次,所有挂载者下一轮上下文都看见。较新的 MemFS 把记忆当 Git 仓库;云上可挂共享 repository,自托管可指到同一 remote。这是「共同读写同一套文件树」,但提交、推送、冲突走 Git,而不是两个进程 append 同一个 MEMORY.md。
Graphiti / Cognee 把多 Agent 观测写成 同一张(或按租户分片的)图:共享的是实体与边,查询时按时间与关系过滤。适合「库存、客户状态、谁在何时改过结论」。
4.3 工作区 Markdown 仍然可用,但不等于总线
OpenClaw 源的真相是磁盘上的 Markdown,检索索引在 SQLite。多 Agent 若 共用一个 workspace 目录,等于共享那一批文件;Dreaming 写 MEMORY.md 有插件状态与锁。多 Agent 各用各的 workspace 则默认不共享,除非做 import、wiki 编译层或外接 Honcho / LanceDB / MemOS 插件。MemOS 的 OpenClaw 插件明确把「多 Agent 协作记忆」做成云或本地 SQLite,而不是指望无协议共写。
MCP 侧车(OpenMemory、Basic Memory)把记忆进程化:各宿主通过同一 MCP 读写。一致性和权限在服务端,文件只是一种后端。
4.4 共享前缀不是共享记忆
agentcache 的 fork 让多个 Worker 复用同一段 Prompt 前缀。它们看到的公共上下文是冻结快照,后续工具结果各写各的尾巴。这解决的是推理缓存复用,不解决「A 刚学到的用户住址,B 也能查」。
| 共享方式 | 技术 | 并发 | 典型产品 |
|---|---|---|---|
| 作用域记录 | 向量 / KV / 图 + user_id 等 | 数据库事务或服务端合并 | Mem0、Supermemory |
| 共享对象 | 同一 Memory Block / Crew Memory | 运行时写入,块级覆盖 | Letta、CrewAI |
| 版本化文件树 | Git / MemFS | 提交级冲突 | Letta MemFS |
| 工作区笔记 | Markdown + SQLite 索引 | 需要锁或单写者巩固 | OpenClaw |
| 时序图 | 节点边 + 有效期 | 图库 | Graphiti、Cognee |
| 共享 Prompt 前缀 | 云 Prompt Cache | 只读前缀 | agentcache |
五、其他功能与应用场景
上面三条没有覆盖、但高星仓库反复出现的能力:
遗忘、取代与合规。 长期记忆必须能改口。Graphiti 用边失效;OpenClaw 在 USER.md 里 superseded 旧指令,并提供 memory forget;Mem0 走 update/delete(新算法也曾强调 ADD-only 再靠检索融合,以产品线为准)。这对应 GDPR 删除、用户更正偏好、过期任务。
时间推理。 「现在的地址」和「去年的地址」同时存在时,只靠相似度会召回错的。Graphiti 的 valid window、Mem0 较新年份的 temporal ranking、日记文件名上的日期衰减(OpenClaw 可配 half-life)都是在打这个问题。
程序记忆与技能结晶。 MemOS、Letta Skills、OpenClaw Skills 把「怎么干活」从对话里拆成可复用技能。这不是用户事实,而是 流程记忆,跨任务复用比复述聊天更稳。
证据与来源。 OpenClaw Dreaming 强调 taint(不信任来源不晋升)、wiki 层保留 claim/evidence;Graphiti 保留 provenance。客服与调研 Agent 需要「这句话从哪次会话来的」。
窗口压缩与记忆冲刷。 上下文满时做 compaction 会丢掉未落盘事实。OpenClaw 默认在摘要前 silent flush;Letta 可在 compaction-event 上触发 dreaming。这是记忆系统与上下文管理的接缝。
用户模型。 Honcho、OpenClaw USER.md、Mem0 用户级记忆把「这个人是谁」从「这个 Agent 是谁」里拆出来,同一用户换 Bot 仍在。
多模态与连接器。 Cognee / Supermemory 强调任意格式 ingest、网盘与聊天连接器。记忆对象从纯文本扩到文件与外部系统快照。
可观测与体检。 Letta /doctor 看记忆是否膨胀、是否重复;OpenClaw /context list 看注入截断。没有这层,MEMORY.md 会在几个月后撑爆 bootstrap 预算。
本地优先与 MCP。 编码 Agent(Claude Code、OpenClaw、Hermes)流行把记忆做成本机插件或 MCP,数据不出机器;云 API 则服务多端同步。同一套抽取算法可以有两种分发。
常见场景对照:
| 场景 | 更贴哪条能力 |
|---|---|
| 客服跨渠道记住用户 | user_id 级事实 + 遗忘纠正 |
| 调研多 Agent 分头搜 | 共享图或 Crew 共享记忆 |
| 个人助理 / 本地管家 | Markdown 日文件 + 梦境巩固 + 人可读审查 |
| 企业知识随时间变化 | 时序图谱,而不是只存向量片段 |
| 重复 FAQ 挡掉重复调用 | GPTCache 类语义缓存 |
| 长任务工具循环 | 系统提示与工具表保持稳定,便于 Prompt Cache 命中 |
六、选型对照
| 目标 | 更合适的方向 | 需要警惕 |
|---|---|---|
| 提高 Prompt Cache 命中 | 稳定系统提示与工具表,动态内容放尾部;多 Worker 时可 fork 前缀 | 把每轮都变的检索块塞进提示前部 |
| 跨周仍认识用户 | Mem0 / Supermemory / Cognee 一类抽取检索 | 把整段聊天当唯一记忆 |
| 人要打开文件审计记忆 | OpenClaw Markdown + Dreaming | 多进程无锁共写同一文件 |
| Agent 自己改自己的人设 | Letta Memory Block + sleeptime | 核心块无限膨胀 |
| 事实会过期、要问历史状态 | Graphiti / Zep | 只用向量相似度 |
| 多 Agent 既隔离又共享用户 | 四维作用域或 scope/slice | 全局一个 namespace |
| 重复问题直接返回 | GPTCache | 当长期记忆用 |
落地时可以叠,但 推理缓存、长期记忆、梦境巩固 应分开配置、分开看指标:Prompt Cache 命中、检索条数、晋升条数,不要用一个数字混报。
七、小结
| 要点 | 结论 |
|---|---|
| 记忆检索 | 抽事实入库,下轮只回灌 Top-K;不存、也不重放整段聊天 |
| 推理缓存 | Prompt / KV Cache 复用稳定前缀;与长期记忆是两套机制 |
| 语义缓存 | 相似问句返回旧答,适合 FAQ,不是人格记忆 |
| 梦境 | 后台 LLM 巩固 + 门控晋升;向量只做检索。日周月是日历金字塔,不是把对话 embed 变短 |
| 跨 Agent | 作用域数据库、共享块、Git、图谱是主流;共写一份 md 只适合单写者工作区 |
| 其余 | 遗忘、时间有效期、技能记忆、来源、压缩前 flush、MCP 本地化,决定能不能上生产 |
先按「要跨会话的事实、要稳定前缀、还是要挡重复 FAQ」选层,再挑仓库。