Mem0记忆组件简介
Mem0 开源默认把抽取后的事实连同向量写入 Qdrant 同一条 point,可用 search 做语义检索,也可用 get/update/delete 按 ID 和过滤做 CRUD。跨 Agent 共享靠同一 collection 上的 user_id 过滤,不落 Markdown。
Mem0记忆组件简介
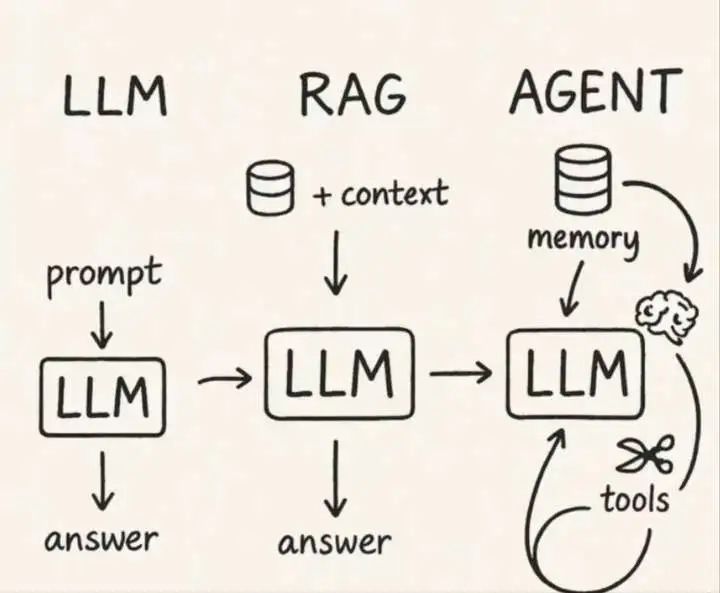
Mem0 定位是 LLM / Agent 的 长期记忆层,不是对话框架,也不是推理引擎。应用把对话交给
add,把检索问句交给search,再决定如何拼进下一次模型请求。落库的是抽取后的事实及其向量,不是聊天原文或 Markdown 文件;跨 Agent 共用同一套库、靠标识符切开。本文说明流程、存储形态、共享方式,以及和语义缓存、Prompt Cache、梦境巩固、时序图谱的边界。接口与后端以官方文档当时说明为准。
参考与延伸阅读:
- GitHub:https://github.com/mem0ai/mem0
- How it works:https://docs.mem0.ai/core-concepts/how-it-works
- Add:https://docs.mem0.ai/core-concepts/memory-operations/add
- Search:https://docs.mem0.ai/core-concepts/memory-operations/search
- Entity-Scoped Memory:https://docs.mem0.ai/platform/features/entity-scoped-memory
- Graph Memory:https://docs.mem0.ai/platform/features/graph-memory
- OSS 概览与默认后端:https://docs.mem0.ai/open-source/overview
- OSS 配置:https://docs.mem0.ai/open-source/configuration
- OSS 算法迁移(实体链接、去掉外接图库):https://docs.mem0.ai/migration/oss-v2-to-v3
- 论文:https://arxiv.org/abs/2504.19413
- GPTCache:https://github.com/zilliztech/GPTCache
- Graphiti:https://github.com/getzep/graphiti
- Letta:https://github.com/letta-ai/letta
- OpenClaw Memory:https://docs.openclaw.ai/concepts/memory
- Prompt Caching 与记忆注入讨论:https://github.com/mem0ai/mem0/issues/4341
目录
一、定位
Mem0 夹在 业务应用 和 对话模型 之间。它不负责排程、工具循环或页面;只负责「哪些事实值得留下」和「下次该回灌哪几条」。
| 项 | 说明 |
|---|---|
| 形态 | 开源 SDK(Apache-2.0)+ 可选托管平台 |
| 主操作 | add、search,以及 get_all / 更新删除 |
| 存什么 | 默认存 抽取后的事实,不是完整对话稿;infer=False 才按原文写入 |
| 存在哪 | 开源默认 Qdrant:一条 point = 向量 + 事实文本 payload。SQLite 只记变更历史。平台可另有托管库与 Graph Memory。没有一等 Markdown 文件库 |
| 作用域 | user_id、agent_id、run_id、app_id 写在同一条记录上,跨 Agent 靠过滤,不靠另开目录 |
| 和 RAG 的差别 | RAG 面向文档库;Mem0 面向 对话里抽出的用户/任务事实 |
没有 Mem0 时,应用往往把聊天记录不断追加进 prompt,会话一断上下文就没了。接上之后:事实存一次,按查询取回,用 user_id 等在用户、Agent、会话之间切开。
GitHub 星数处于记忆组件第一档(调研当时约六万级),并提供 CrewAI、AutoGen、LangGraph 等接入说明。星数只说明关注度,不等于它能替代所有「带检索的缓存」。
二、add 与 search
官方推荐节奏只有两步:
- 有值得记住的交互之后 调
add。 - 下一次调对话模型之前 调
search,把返回条目交给应用去拼 prompt。
add 默认 infer=True:用 LLM 从消息里抽出偏好、决策、计划,丢掉寒暄。内部大致是:按同一作用域查已有记忆避免重复 → 抽取 → 去重并 embedding → 抽实体。平台版实体会链进 Graph Memory,检索时给相关记忆加分。infer=False 才按原文存消息,和抽取混用容易变成两条重复记忆。
托管平台在抽取时,可按同一 user_id(及可选 run_id)自行带上近期消息,用来消解「他 / 那个仓库」之类指代,应用不必每次重传几个月的全文。这只用于抽取上下文,不等于把全文当主存储。
search 把问句做成向量,融合语义相似、关键词(BM25)、实体重叠、时间信号后排序,必须带 filters(至少 user_id),否则用户之间会串。top_k 控制回灌条数。
应用拼 prompt 的方式由自己决定:Mem0 只返回记忆文本和分数,不替你调对话模型。
三、对话如何落库
先分清 送进去的 和 留下来的。add 接收的是 user / assistant 消息列表;默认写进库的是短事实,不是那一轮对话的逐字稿。
| 输入 | 默认存下的记忆 |
|---|---|
"I prefer aisle seats" | User prefers aisle seats |
"Let's use Postgres for this project" | Project decision: use Postgres |
消息上的 user_id 等 | 过滤字段,检索时用来切开范围 |
官方说法是:你把消息交给 Mem0,Mem0 默认存 extracted memories。要留原文才设 infer=False。多数产品只把值得复用的偏好、决策、账号事实送进 add,寒暄和一次性闲聊不要入库。
不是 Markdown 文件
Mem0 没有 MEMORY.md、按日切的 YYYY-MM-DD.md、Git 工作区这类一等存储。它不是 OpenClaw 那种「人读文件 + SQLite 索引」。需要审计稿、导出给同事改,得应用自己从 get_all / 平台仪表盘拉出来再写成文件。跨 Agent 共享也 不是 两个 Bot 共写一份 Markdown。
开源自建:Qdrant 一条点里同时放向量和事实文本
库内 Memory() 的默认向量后端是 Qdrant(路径约 /tmp/qdrant,collection 默认 mem0)。开源实现里,活着的记忆就在向量库的 point 上,不是「向量一份、事实另存一份关系表」。
一条记忆在 Qdrant 里大致是:
| 部位 | 内容 | 用途 |
|---|---|---|
| vector | 事实文本的 embedding | search 语义相似(可再叠 BM25) |
payload data | 事实原文,如「周报只要风险和阻塞」 | 回灌给模型、按 ID 读出 |
| payload 其它字段 | user_id / agent_id / run_id、hash、时间、过期日、可选 metadata | 过滤、去重、作用域 |
并行 collection {name}_entities | 实体的向量与文本 | 实体重叠加分,不是第二份对话稿 |
所以默认就是:Qdrant 同时存向量和事实文本。 换成 pgvector、Redis 等也是同一模式:向量和文本绑在一条记录上。官方 How it works 写的「SQL 存事实、向量库存 embedding」更接近 平台托管 的概念拆分;开源 SDK 没有再挂一套独立的记忆业务表。旁边的 SQLite(~/.mem0/history.db)只记 变更历史(某条记忆从旧文本变成新文本),不是主库。Python 侧 history 长期只接 SQLite,多实例不要指望各写一份本地 history 还一致。
可换的向量后端包括 Qdrant、pgvector、Chroma、Pinecone、Redis、Weaviate、Milvus、Elasticsearch 等(以配置页为准)。自托管 server/ Docker 默认是 Postgres + pgvector:向量和文本可以落在同一张表里,观感更接近数据库,语义仍是「一条记忆一行(一个向量)」。
向量检索和 CRUD 都有,但 CRUD 走的是点操作
Mem0 对外同时提供两类读:
| 能力 | 接口 | 底层 |
|---|---|---|
| 按意思找 | search(Top-K + filters) | 向量相似,可选 BM25;再用 payload 过滤作用域 |
| 按条件列出 / 按 ID 取 | get、get_all | 按 payload 过滤或按 point id 取,不靠「像不像」 |
| 改与删 | update、delete、delete_all | 更新或删掉对应 point,history 记一笔 |
这不是关系库那种 SQL JOIN / 事务 CRUD。Qdrant 仍是向量库:没有表连接,过滤是 payload 条件(user_id=user-jia)。「既有向量检索又有增删改查」成立的层次是 Mem0 封装了 point 的写入、按 ID 读写、按过滤列出,以及语义 search。get_all(filters={"user_id": "user-jia"}) 是结构化列出;search("周报怎么写", filters=...) 才是按问句打分截 Top-K。
生产环境应显式设 collection_name,按租户或环境切开 collection。那是 运维隔离,和「客服 Bot 与经理 Bot 共用用户甲的偏好」不是同一件事:后者默认仍在 同一个 collection 里,靠记录上的 user_id / agent_id 过滤。
图谱:检索加分,不是第三份对话稿
「有没有图谱存储」容易和 Graphiti 那种可遍历时序图混在一起。Mem0 当前口径是:
- 平台 Graph Memory:内建,不必自备 Neo4j。节点是记忆里提到的实体,边来自 共现(多条记忆提到「客户 A」就连起来),不写「甲 manages 乙」这类带类型关系。检索时给连上的记忆加分,搜索接口仍返回普通记忆列表,没有单独的图 payload。仪表盘里可点开的 Graph view 要 Pro / Enterprise。
- 开源新算法:外接
graph_store(Neo4j、Memgraph、Kuzu、Apache AGE、Neptune)已从 SDK 拿掉。实体写进向量库里并行 collection({collection}_entities),用链接给score加分。这不是再维护一套可 Cypher 遍历的业务图。 - 配置页仍可能写「Graph memory 只在 Platform」:和迁移文档对照时,以「OSS 无外接图库、有实体链接;可交互的图视图在平台」理解为准。
因此:对话内容 不会 再存成一份独立「图谱稿」。图只是实体索引。要「上周二当时系统相信什么、哪条边已失效」,仍应看 Graphiti 一类时序图,而不是 Mem0 的 Graph Memory。
四、跨周助手示例
人物与项目已脱敏。用户甲是实施顾问。周一说过:负责客户 A、周报只要风险和阻塞、代码在 GitLab、群里不要 @ 分管领导。下周五只说:「按我习惯写一份本周周报提纲。」
应用固定 user_id="user-jia"。周一结束后把那几轮交给 add,库里留下短事实,而不是二十轮 transcript。周五不贴周一全文,而是用当前问句 search,top_k 取数条。回灌结果接近:
1
2
3
4
5
相关记忆:
- 用户甲负责客户 A 的实施。
- 周报只要风险和阻塞,不要过程流水账。
- 群内不要直接 @ 分管领导。
用户:按我习惯写一份本周周报提纲。
对话模型据此写出带风险/阻塞结构的提纲。GitLab 那条仍在库里,本轮用不上就不送;以后问合并门禁再召回。换设备或新开 run_id,只要仍按 user_id 搜,这批事实还在。门禁助手若用同一个 user_id="user-jia" 检索,也能共用这几条用户偏好;它自己的 runner 私货不会出现在周报助手的 Top-K 里,见下一章的逐行数据。
Mem0 公开基准把单次检索预算压在数千 token 量级,依据的就是「只回灌相关事实」。周五那句以前没出现过,仍然要调对话模型;Mem0 不替代生成。
五、跨 Agent 共享
跨 Agent 共用记忆,不是 再选一种存储格式。客服 Bot 和经理 Agent 连的是 同一个 Qdrant collection(或你换成的 pgvector 表)。共享靠写入时打上的标识符,检索时用 filters 对齐。
| 字段 | 用途 |
|---|---|
user_id | 这个人的长期偏好与事实 |
agent_id | 某个 Bot 的私有记忆(人设、内部草稿) |
run_id | 本轮 / 本次任务 |
app_id | 应用 / 租户级标签 |
周报 Bot 与门禁 Bot 共用用户甲
仍是用户甲。两个 Agent 连 同一个 Qdrant collection mem0,不另开库、不共写 Markdown。
| Agent | agent_id | 职责 |
|---|---|---|
| 周报助手 | weekly-bot | 写周报提纲、催截止 |
| 门禁助手 | gitlab-bot | 回答合并流水线、runner |
周一用户甲对周报助手说了偏好;周报助手自己还记了一条「草稿先私发」。门禁助手另记了一条内部 runner 标签。默认抽取下,用户说的事实 落到 user_id="user-jia"、agent_id 为空;助手说的流程 落到对应 agent_id、user_id 为空。库里的 point 如下(ID 与后文 Top-K 示例共用):
| ID | payload data | user_id | agent_id | 谁能当「用户记忆」共享 |
|---|---|---|---|---|
| M1 | 用户甲负责客户 A 的实施。 | user-jia | (空) | 两个 Bot 都能搜到 |
| M2 | 周报只要风险和阻塞,不要过程流水账。 | user-jia | (空) | 两个 Bot 都能搜到 |
| M3 | 代码托管 GitLab,合并前必须过流水线。 | user-jia | (空) | 两个 Bot 都能搜到 |
| M4 | 群内不要直接 @ 分管领导。 | user-jia | (空) | 两个 Bot 都能搜到 |
| M5 | 周报截止周五 17:00(Asia/Shanghai)。 | user-jia | (空) | 两个 Bot 都能搜到 |
| M6 | 客户 A 的接口人是李工。 | user-jia | (空) | 两个 Bot 都能搜到 |
| A1 | 周报草稿先私发给用户甲,不要进客户群。 | (空) | weekly-bot | 仅周报助手 |
| A2 | 内部排查用 runner 标签 docker-build,不要写进客户周报。 | (空) | gitlab-bot | 仅门禁助手 |
周五同一句问:「按我习惯写一份本周周报提纲。」top_k=3。分数仍是示意。
周报助手 要共用用户习惯,也要带上自己的私发规则,过滤用 OR:
1
2
3
4
filters = {"OR": [
  {"user_id": "user-jia"},
  {"agent_id": "weekly-bot"}
]}
| 排名 | ID | 示意分数 | 原因 |
|---|---|---|---|
| 1 | M2 周报只要风险和阻塞 | 0.91 | 用户共享记忆 |
| 2 | A1 草稿先私发 | 0.86 | 本 Bot 私有,门禁助手看不到 |
| 3 | M5 周五 17:00 截止 | 0.78 | 用户共享记忆 |
回灌:M2、A1、M5。提纲按风险/阻塞写,并且先私发给甲。A2 的 agent_id 是 gitlab-bot,不在 OR 里,候选集里根本没有。
门禁助手 若被同一用户问了同一句(例如甲在门禁窗口里顺口让它帮忙拟周报),过滤换成:
1
2
3
4
filters = {"OR": [
  {"user_id": "user-jia"},
  {"agent_id": "gitlab-bot"}
]}
| 排名 | ID | 示意分数 | 原因 |
|---|---|---|---|
| 1 | M2 周报只要风险和阻塞 | 0.91 | 同一条用户记忆,共享成功 |
| 2 | M5 周五 17:00 截止 | 0.78 | 共享 |
| 3 | M4 不要 @ 分管领导 | 0.74 | 共享;A1 不在候选集,M4 递补进 Top-3 |
回灌:M2、M5、M4。门禁助手也能按甲的周报习惯写提纲(这就是跨 Agent 共享),但 不会 看见「草稿先私发」,也 不会 把 runner 标签 A2 塞进周报——A2 对本问分数低(示意 0.12),即便在候选集里也进不了 Top-3。
只滤 {"user_id": "user-jia"} 时,两个 Bot 拿到的都是 M1~M6 那一档,都看不到 A1 / A2。这是「只共享用户画像、Bot 私货不上桌」的写法。
1
2
# 错:默认抽取下没有「两字段同时有值」的行,结果经常是空
{"AND": [{"user_id": "user-jia"}, {"agent_id": "weekly-bot"}]}
Microsoft Agent Framework 的接入还把 写入范围 和 检索范围 拆开:共享 agent_id 写入的内容,默认不会在检索时自动带上,必须显式配置 search_agent_id。
平台默认抽取路径有一条容易踩坑的规则:一次 add 同时传 user_id 和 agent_id,不会得到两条字段都填满的记录。 用户说的事实写成 user_id 有值、agent_id 为空;助手说的事实写成 agent_id 有值、user_id 为空。app_id / run_id 倒是每条都带。于是:
{"user_id": "user-jia"}能命中用户甲的偏好(官方还说明:只滤用户时,不要求 其它字段为空,带了agent_id的记录也可能回来,和早期「只返回空 agent」的说法要以当前文档为准)。{"AND": [{"user_id": "..."}, {"agent_id": "..."}]}在默认抽取下经常是空的,因为没有「两字段同时有值」的行。要两边都搜,用OR。- 一条记录上同时带齐
user_id和agent_id,主要来自infer=False的原文导入。
作用域一旦写入就难无损改标签。上线前定清:用户画像写用户级、Bot 私货写 Agent 级、工单用 run_id 并定期 delete_all。需要物理隔离时再拆 collection_name 或拆项目,那是租户墙,不是 Bot 之间共享用户记忆的默认做法。
六、局限与覆盖不到的层
Mem0 覆盖的是 长期事实记忆。下面几层经常被当成「也是记忆」,机制不同,Mem0 单独做不到或做不好。
不是语义缓存。 GPTCache 对相似问句 直接返回上次完整回答,不再调对话模型。Mem0 的语义相似度只用在 召回事实,召回之后仍要生成。同一句「密码怎么重置」:语义缓存可能秒回旧答;Mem0 可能召回「用户用邮箱登录」,再让模型写新说明。FAQ 挡流量应另接语义缓存,不要指望 Mem0 少打 API。
不是 Prompt / KV Cache。 云厂商 Prompt Caching 和推理引擎的前缀 KV 要求提示 从第一个 token 起连续相同。Mem0 的 search 每轮按 当前问句 重打分,只回灌分数最高的 K 条(Top-K)。这 K 条的成员、顺序、分数都会变。把它们写进系统提示前部,等于每轮换掉提示开头,缓存从分叉点整段作废。仓库讨论 issue #4341 的建议是:系统提示保持不动,记忆走 工具返回 或 单独消息。Mem0 不实现前缀复用,默认示例若把记忆贴进 system 前部,还可能和缓存打架。
下面用用户甲库里的事实,把「每轮 Top-K」写成可对照的数字。top_k=3 只是举例;开源新算法默认曾把 top_k 收到 20,生产上常见 5~10。ID、作用域与第五章同一张表:M1~M6 是用户共享记忆(user_id=user-jia,agent_id 空);A1 只属于 weekly-bot,A2 只属于 gitlab-bot。
第 1~3 轮假定检索方是周报助手,且过滤只带 {"user_id": "user-jia"},因此 A1 / A2 不进候选集,表里只给 M1~M6 打分。分数是示意(0~1),不是某次真实 API 回包。
| ID | 事实 | user_id | agent_id | 约 token |
|---|---|---|---|---|
| M1 | 用户甲负责客户 A 的实施。 | user-jia | (空) | 12 |
| M2 | 周报只要风险和阻塞,不要过程流水账。 | user-jia | (空) | 16 |
| M3 | 代码托管 GitLab,合并前必须过流水线。 | user-jia | (空) | 16 |
| M4 | 群内不要直接 @ 分管领导。 | user-jia | (空) | 14 |
| M5 | 周报截止周五 17:00(Asia/Shanghai)。 | user-jia | (空) | 16 |
| M6 | 客户 A 的接口人是李工。 | user-jia | (空) | 12 |
| A1 | 周报草稿先私发给用户甲,不要进客户群。 | (空) | weekly-bot | 18 |
| A2 | 内部排查用 runner 标签 docker-build,不要写进客户周报。 | (空) | gitlab-bot | 22 |
第 1 轮。 问句:「按我习惯写一份本周周报提纲。」search(..., top_k=3):
| 排名 | ID | 示意分数 | 进不进 Top-3 |
|---|---|---|---|
| 1 | M2 周报只要风险和阻塞 | 0.91 | 进 |
| 2 | M5 周五 17:00 截止 | 0.78 | 进 |
| 3 | M4 不要 @ 分管领导 | 0.74 | 进 |
| 4 | M1 负责客户 A | 0.61 | 被丢掉 |
| 5 | M3 GitLab 流水线 | 0.33 | 被丢掉 |
| 6 | M6 接口人李工 | 0.22 | 被丢掉 |
回灌文本固定长约 50 token,内容是 M2 → M5 → M4。M3 再相关也进不了本轮窗口,这就是 K 的截断。
第 2 轮。 用户接着问:「合并到主分支前要过哪些门禁?」还是 top_k=3:
| 排名 | ID | 示意分数 | 进不进 Top-3 |
|---|---|---|---|
| 1 | M3 GitLab 流水线 | 0.93 | 进(上轮第 5,本轮第 1) |
| 2 | M1 负责客户 A | 0.70 | 进(上轮第 4) |
| 3 | M6 接口人李工 | 0.64 | 进(上轮第 6) |
| 4 | M2 周报格式 | 0.41 | 被丢掉(上轮第 1) |
| 5 | M5 周五截止 | 0.29 | 被丢掉 |
| 6 | M4 不 @ 领导 | 0.18 | 被丢掉 |
集合从 {M2, M5, M4} 换成 {M3, M1, M6},三条全换。顺序也按新分数重排。库没变,变的是 这一问的排序截断。
第 3 轮。 「周报里要不要写流水线失败?」:
| 排名 | ID | 示意分数 | 进不进 Top-3 |
|---|---|---|---|
| 1 | M2 周报只要风险和阻塞 | 0.88 | 进 |
| 2 | M3 GitLab 流水线 | 0.81 | 进 |
| 3 | M5 周五截止 | 0.57 | 进 |
| 4 | M4 不 @ 领导 | 0.40 | 被丢掉 |
和第一轮比:M2、M5 还在,但中间插进了 M3,M4 被挤出;和第一轮字符串已经不同。即便某两轮碰巧召回同一组 {M2, M5, M4},只要分数导致 顺序 从 M2,M5,M4 变成 M2,M4,M5,拼出来的文本也不是同一前缀。
同一问句、两个 Agent。 问句仍是「按我习惯写一份本周周报提纲。」top_k=3。和第一轮的差别不在问句,而在 过滤把谁放进候选集。
周报助手 OR(user_id=user-jia, agent_id=weekly-bot):
| 排名 | ID | 示意分数 | 进不进 Top-3 |
|---|---|---|---|
| 1 | M2 周报只要风险和阻塞 | 0.91 | 进(共享) |
| 2 | A1 草稿先私发 | 0.86 | 进(仅本 Bot) |
| 3 | M5 周五截止 | 0.78 | 进(共享) |
| — | A2 runner 标签 | — | 不在候选集 |
门禁助手 OR(user_id=user-jia, agent_id=gitlab-bot),同一问句:
| 排名 | ID | 示意分数 | 进不进 Top-3 |
|---|---|---|---|
| 1 | M2 周报只要风险和阻塞 | 0.91 | 进(与周报助手共享同一条) |
| 2 | M5 周五截止 | 0.78 | 进 |
| 3 | M4 不要 @ 领导 | 0.74 | 进(A1 不可见,名次前移) |
| — | A1 草稿先私发 | — | 不在候选集 |
| 6 | A2 runner 标签 | 0.12 | 在候选集但被 Top-3 丢掉 |
两轮(两个 Bot)的 Top-K 文本分别是 M2,A1,M5 与 M2,M5,M4。共享的是用户事实 M2 / M5;私有流程互不泄漏。对 Prompt Cache 来说,这又是一次前缀分叉:同一用户、同一问句,只因检索方的 agent_id 不同,系统提示前部若拼了 Top-K 也会整段失配。
若把 Top-K 写进系统提示最前面。 人设和工具表假设共约 1800 token(超过云厂商常见的 1024 token 起缓存门槛)。错误拼法:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 第 1 轮发给对话模型的开头
system:
相关记忆:
- 周报只要风险和阻塞,不要过程流水账。
- 周报截止周五 17:00(Asia/Shanghai)。
- 群内不要直接 @ 分管领导。
你是实施助手,……(后面 1800 token 人设与工具 JSON)

# 第 2 轮同一位置
system:
相关记忆:
- 代码托管 GitLab,合并前必须过流水线。
- 用户甲负责客户 A 的实施。
- 客户 A 的接口人是李工。
你是实施助手,……(人设与工具 JSON 一字未改)
Prompt Cache 从左往右比。两轮在大约第 8 个 token(「相关记忆」之后的第一条)就分叉。后面那 1800 token 人设虽然相同,但已经不在 连续相同前缀 里,不能当缓存命中。第 1 轮若写入了约 1850 token 的前缀,第 2 轮几乎整段按未命中计价、整段重做 prefill。折扣以各云账单为准;机制上就是「开头几个字一变,后面整段作废」。
若人设在前、Top-K 在后(或当工具结果)。
1
2
3
system: 你是实施助手,……(1800 token,两轮字节级相同)
user:   相关记忆:……(仅此处随 Top-K 变)
user:   本轮用户问题
前 1800 token 可以命中上一轮写入的缓存;变化被关在尾部。记忆仍每轮不同,这是检索该做的事,只是不要把它放进必须稳定的那一段。
所以「每轮 Top-K 都在变」不是说向量库每轮被改写,而是:同一批事实,按本轮问句排序截断后,送进模型的那 K 行文本几乎轮轮不同。 这和 Prompt Cache 要的「提示开头别动」正好相反。
没有日周月梦境工作流。 它按消息(或一批消息)抽取,不按 YYYY-MM-DD.md 切日记,也没有 OpenClaw Dreaming / Letta sleeptime 那种后台巩固、门控晋升、人读 MEMORY.md。日历金字塔、Git 工作区审查要另选。存储层也补不出这套文件纪律。
时序图不是主业。 平台 Graph Memory / OSS 实体链接用共现给检索加分,能把「客户 A」相关事实连起来。它回答不好「上周二当时系统相信什么、哪条边已失效」。那种问题更贴近 Graphiti 的 valid_at / superseded。不要把 Mem0 的图层当成可导出的业务知识图谱。
不替 Agent 改常驻人设块。 Letta 的 Memory Block 每轮钉在上下文里,由 Agent 或 sleeptime 子 Agent 改写。Mem0 返回的是检索列表,人设要应用自己拼;没有「核心块无限膨胀」的运行时,也没有运行时替你管理块预算。
抽取有成本、也有丢信息。 每次 add 通常要额外 LLM 调用。寒暄被丢掉是优点,但过程细节、未说完的约束可能抽不出来。infer=False 能留原文,库会变吵。冲突处理在平台新算法里偏 ADD-only 再靠检索融合,和旧版 UPDATE/DELETE 行为不同,升级要看迁移说明。
检索不是保证召回。 Top-K 可能漏掉本轮用得上的一条(示例里周五不带回 GitLab)。作用域配错会空结果或串用户。这是记忆层的常规风险,不是 Mem0 独有,但「接了就能当完整大脑」不成立。
七、与其它组件对照
| 需求 | Mem0 | 通常还要另选 |
|---|---|---|
| 跨会话记住事实与偏好 | 本职;事实进向量库 payload | — |
| 多 Bot 共享同一用户、隔离私有草稿 | 同一库 + user_id / agent_id 过滤 | — |
| 人读 Markdown / 按日文件 | 无此存储 | OpenClaw、自建导出 |
| 可遍历时序知识图谱 | 实体共现加分,不是 typed 时序图 | Graphiti / Zep |
| FAQ 相似问不调模型 | 弱 | GPTCache 等语义缓存 |
| 长任务复用 Prompt 前缀 | 不负责;检索块放系统提示前部会损害命中 | 提示布局;多 Worker 可用 agentcache |
| 日文件 + 梦境巩固 | 无 | OpenClaw、Letta sleeptime |
| Agent 自改常驻人设 | 应用侧拼 prompt | Letta Memory Block |
| 文档知识库 | 不是主场景 | 常规 RAG |
可以叠:Mem0 管用户事实,GPTCache 挡 FAQ,系统提示保持稳定以照顾 Prompt Cache,图谱或工作区文件补专精场景。叠的时候分开接、分开看指标,不要用一个「命中率」混报。
八、适用边界
适合。 多端、多 Bot 要共用一份用户画像;不想把整段聊天塞进窗口;已经有自己的 Agent 框架,只缺记忆 CRUD;可以接受事实进数据库 / 向量库,而不是进 Git 里的 md。
不适合当唯一底座。 主要痛点是重复 FAQ、推理账单上的 prefix 命中、必须打开 Markdown 做审计、或要 Cypher 查「当时哪条边有效」。这些应先选对应组件,Mem0 顶多做配角。
作用域一旦写入就难改:上线前定清哪些记在用户级、哪些记在 Agent 级、会话级要不要单独 run_id。自建还要定向量库与是否接受本地 SQLite history。
九、小结
| 要点 | 结论 |
|---|---|
| 是什么 | 长期事实记忆层:add 抽取,search 回灌 Top-K |
| 存什么 | 默认短事实,不是对话全文;原文要 infer=False |
| 存在哪 | 开源默认 Qdrant 一条点内存向量+文本;history 用 SQLite。无 Markdown 主存储 |
| 跨 Agent | 同一套库,靠 user_id / agent_id 等过滤;不是每人一份文件、也不是另开图库 |
| 擅长 | 跨会话、跨设备、跨 Bot 记住用户与任务事实 |
| 不替代 | 语义缓存、Prompt Cache、梦境日历、完整时序图、常驻 Memory Block |
| 接入注意 | 检索结果放提示后部或工具里;写入/检索作用域显式分开;平台抽取会把 user/assistant 事实拆到不同字段 |
| 选型 | 多 Bot 共用用户记忆可当底座;其它层按需叠加 |
先确认要的是「记住这个人」,还是「挡住重复问题」或「复用提示前缀」,再决定 Mem0 是主路径还是配角。