Leiden社区检测应用案例与建边范式简介
先按业务规则建边构图,再用社区圈团伙,把社区号喂给下游。弱共现边必须去噪加权;系统应敢于输出「此人无可判定关系」,而不是硬塞进某个群。
先按业务规则建边构图,再用社区圈团伙,把社区号喂给下游。弱共现边必须去噪加权;系统应敢于输出「此人无可判定关系」,而不是硬塞进某个群。
工程里最常指群体稳定性指数:用分箱占比差看两批样本有没有漂。分数段结构变了,线上效果就不能拿训练期指标硬套,并对照相关监控指标。
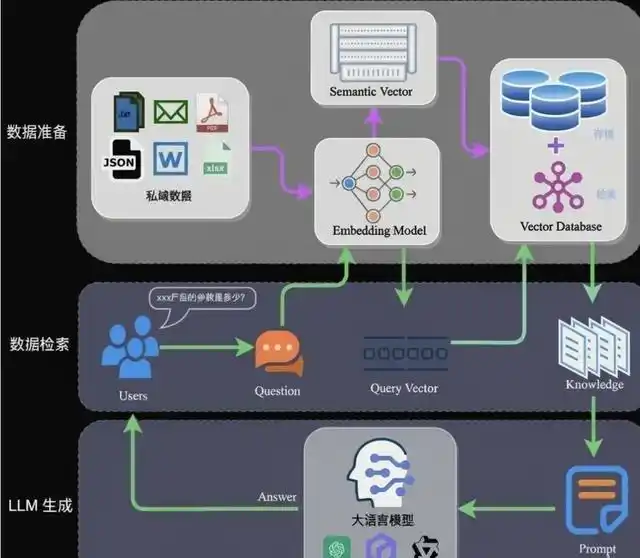
国内网络用 Compose 拉 v0.26.4,默认 Elasticsearch 加 CPU 共五个镜像,可换成华为云仓库。须满足内存、内核映射数和端口;知识图谱需要更高配置。
Docker 私有化常见卡解析、任务执行器未起、外接向量服务。升级须整套替换 docker 目录,不能只改镜像;操作前停服备份,可接受清数据时再重建卷。
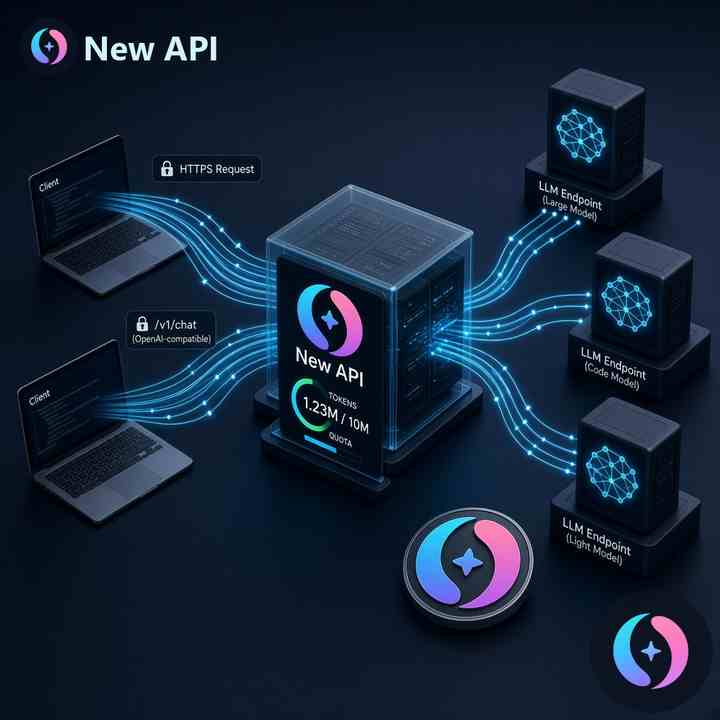
渠道模型列表须包含请求里的产品名,定价也要按该名称单独配置,否则会无可用渠道或报价格未配置。系统访问令牌用于开户改额度,与用户对话 sk 不是同一类凭证。
OpenAI 兼容的大模型网关,统一管理上游渠道与 Key,按用户积分扣费、额度不足即拒绝。适合私有化部署和线下加额,并说明 AGPL、Compose 与用户令牌调用。
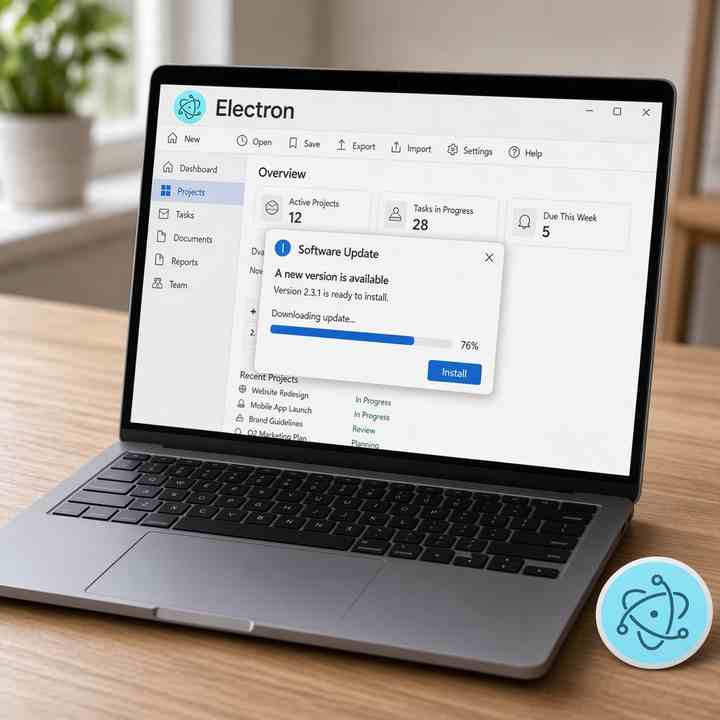
Windows 上用 electron-builder 打 NSIS 包,electron-updater 走 HTTPS 静态源更新。差分只少下数据块,形态仍是全量覆盖安装,并说明 latest.yml 与 Nginx。
改进模块度划分,保证每个社区内部连通,通常比鲁汶更快、质量更好。说明三阶段流程、分辨率和质量函数,以及 Python 库怎么选划分类型。
前者在单表上用算子组合并按模型效果筛选,后者沿多表关系做深度合成。数据形态不同,选型先看有没有实体关系,而不是谁更新。
树深、学习率等须在训练前选定。从固定配置、网格和随机搜索讲到贝叶斯优化与交叉验证估计器,对照成本与适用面,以表格模型和 scikit-learn 为主。